Recherche · Analyse
ARC-AGI-3 : de 62,7 % à 99,9 % pour le même modèle, selon la façon dont on le branche
La fondation ARC Prize a mesuré GPT-6 Astra sur son banc d'essai de jeux interactifs, lancé en mars. Le score passe de 62,7 % à 99,9 % en changeant seulement la gestion de la mémoire entre deux appels. La fondation précise qu'un test saturé ne prouve pas une intelligence générale.
Par Kayzen AI · · 3 min de lecture
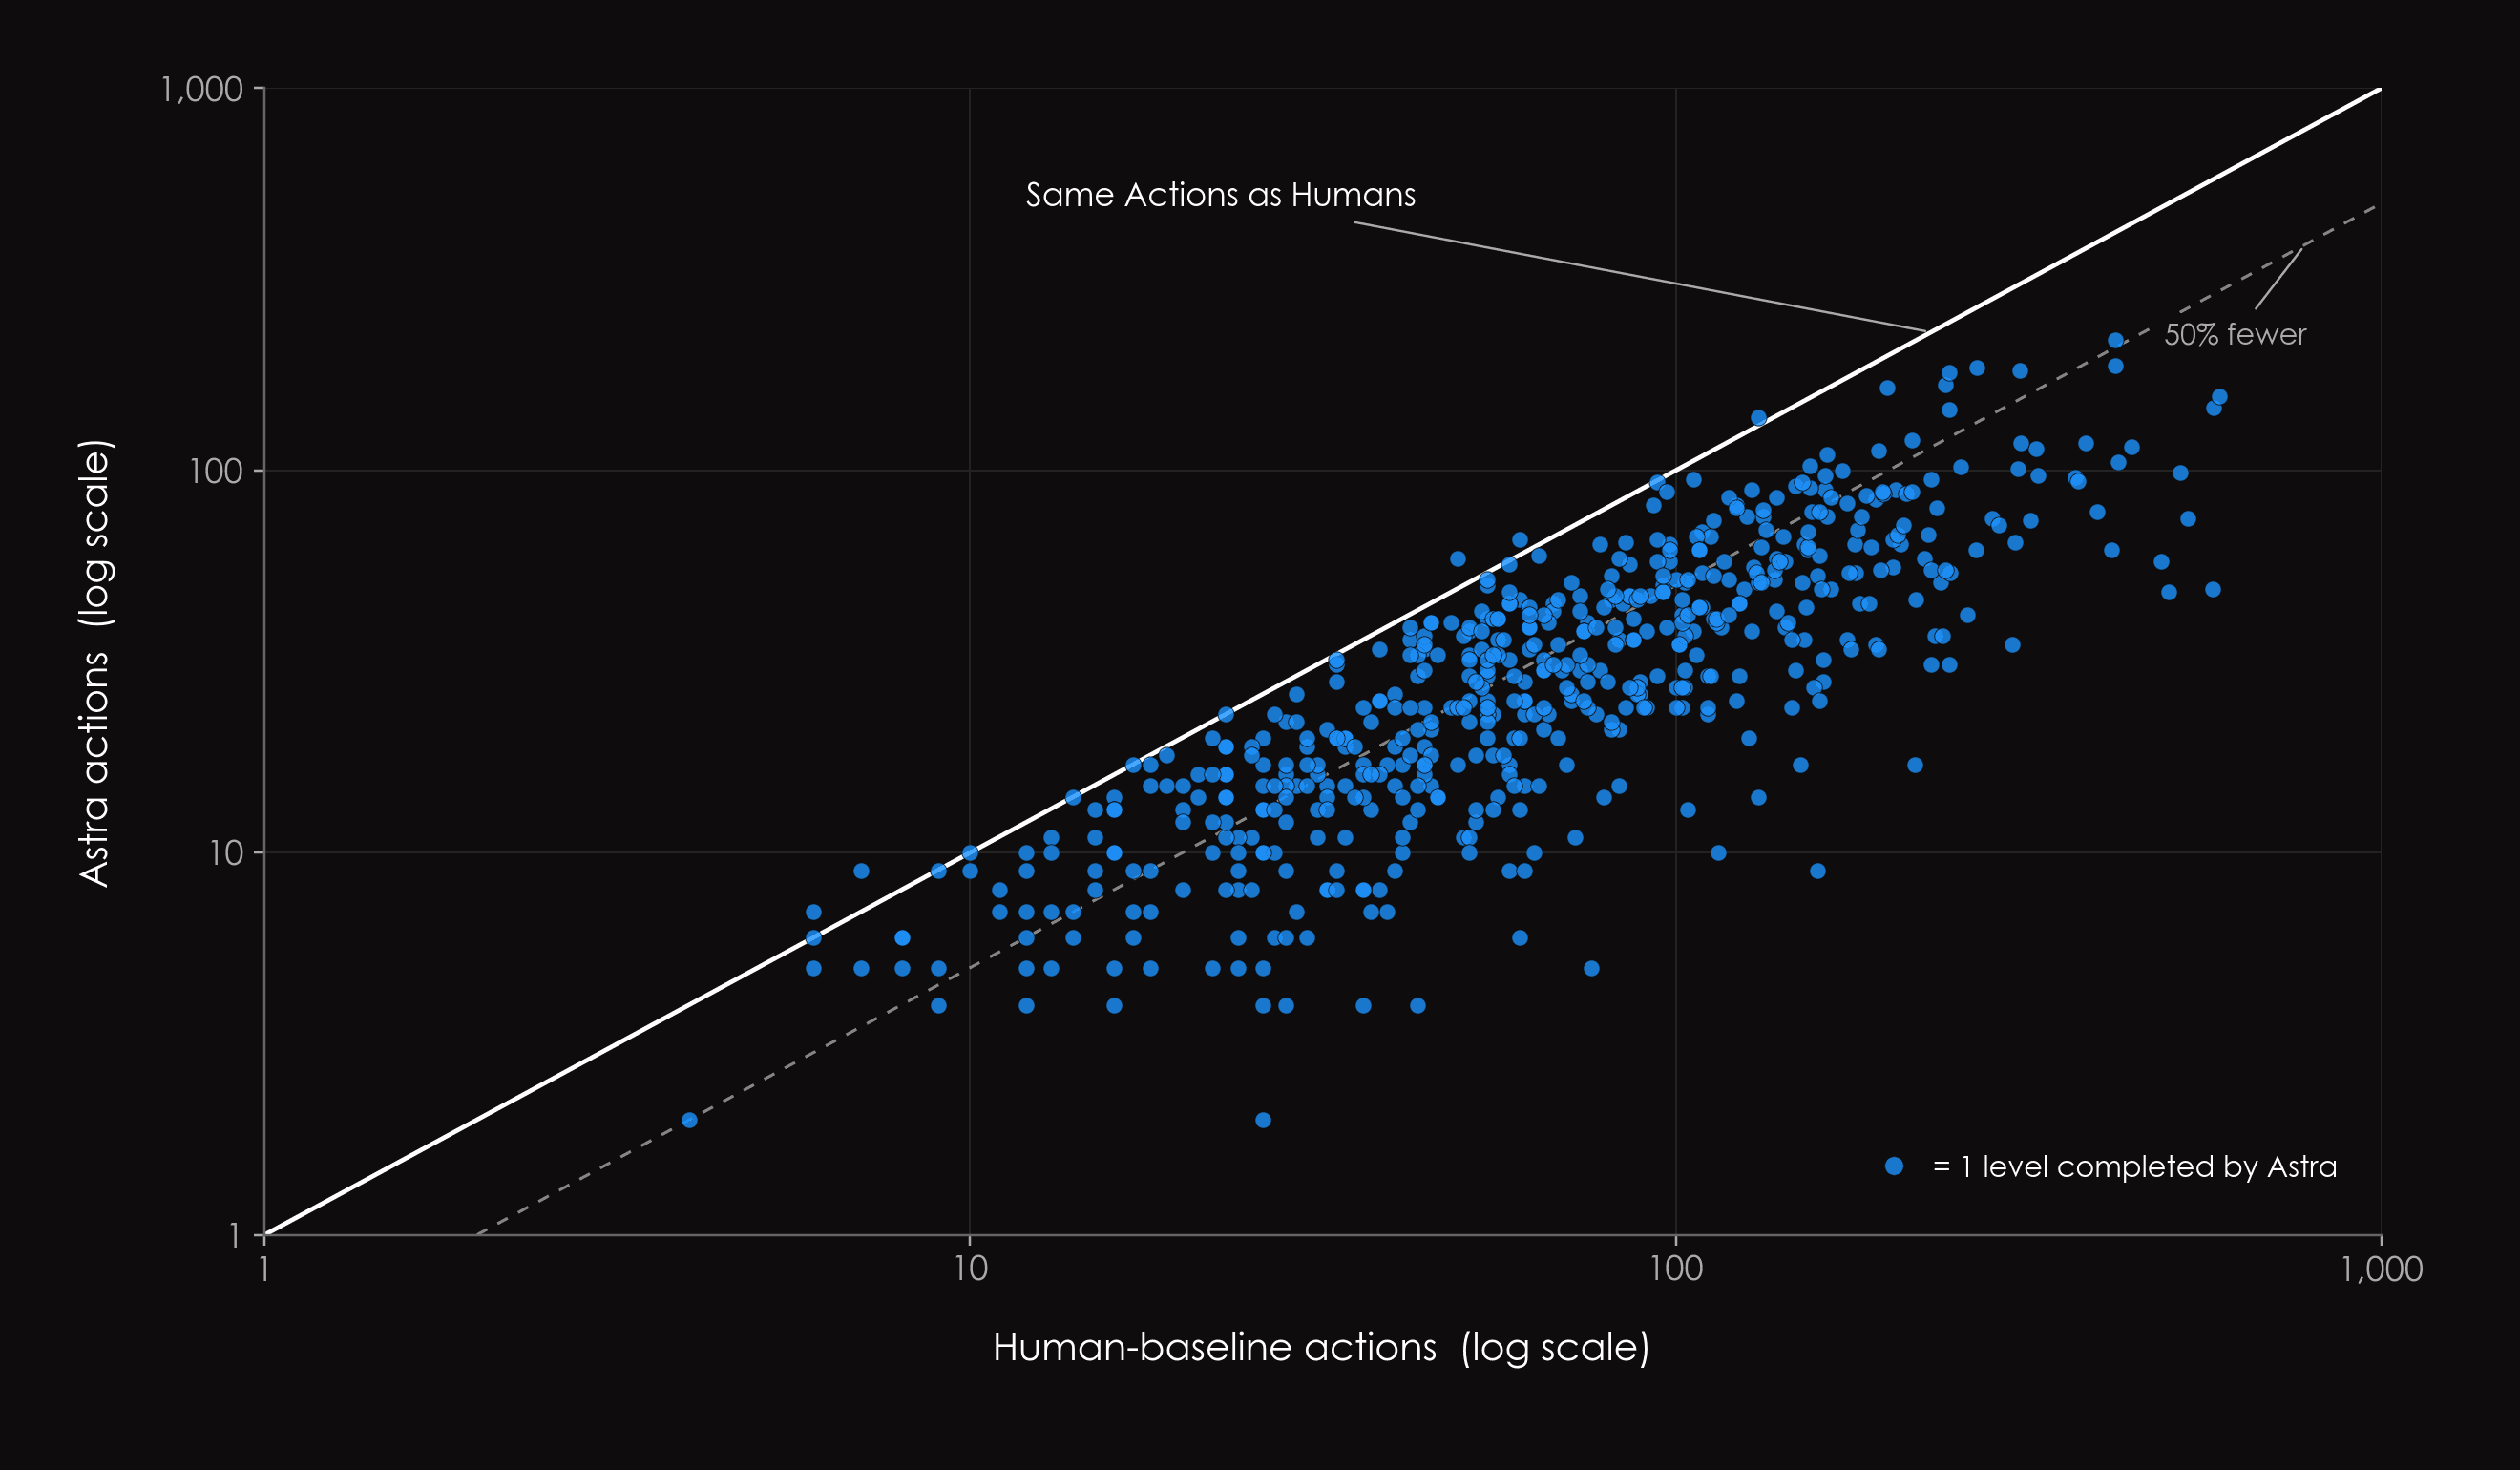
ARC-AGI-3 a été lancé en mars 2026 pour mesurer ce que les tests classiques ne voient pas : la capacité d'un système à se débrouiller dans une situation inconnue. Dans une analyse publiée le 3 septembre 2026, la fondation ARC Prize rapporte que le modèle GPT-6 Astra d'OpenAI atteint 99,9 % sur le jeu d'évaluation semi-privé. Les résultats du concours ARC Prize 2026, désormais clos, sont attendus le 4 décembre : c'est le moment de relire ces chiffres.
Ce que mesure le test
Le système est placé dans de petits jeux abstraits, au tour par tour, sans aucune consigne. Il doit explorer, comprendre les règles, deviner l'objectif, puis planifier. Le test ne regarde pas seulement si le jeu est terminé, mais en combien d'actions.
La référence humaine vient d'environ 500 personnes du grand public, non sélectionnées pour leur goût des casse-têtes. Pour chaque niveau, la fondation retient le nombre médian d'actions des joueurs qui l'ont terminé.
Deux branchements, deux résultats
La fondation a testé le même modèle de deux façons :
- Branchement standard : interface minimale, identique pour tous les fournisseurs. Le modèle ne conserve d'un appel à l'autre que les notes qu'il choisit de garder. Meilleur score : 62,7 %, pour 26 098 dollars.
- Branchement fournisseur : l'état de raisonnement du modèle est préservé entre les requêtes, avec compression des longues conversations. Meilleur score : 99,9 %, pour 18 817 dollars.
Avec le second, tous les niveaux d'effort de raisonnement dépassent 96 %. Avec le premier, les scores s'étalent de 17,5 % à 62,7 %. Sur les 167 parties résolues dans les deux cas, le branchement fournisseur a été environ 3,66 fois plus rapide et a consommé 49 % de jetons en moins.
Autre constat de la fondation : un effort de raisonnement plus élevé coûte généralement moins cher au total, parce que le modèle a besoin de moins d'actions pour résoudre un jeu.
Dans sa meilleure configuration, Astra utilise moins d'actions que la référence humaine sur 96,0 % des niveaux.
Les réserves
Elles sont formulées par la fondation elle-même :
- saturer le test n'est pas une preuve d'intelligence artificielle générale, et elle ne prétend pas qu'Astra en soit une ;
- le test a un périmètre borné : des règles déterministes et des objectifs fermés, loin de la complexité du monde réel ;
- dans un montage avancé, le modèle disposait d'un bac à sable pour écrire ses propres outils, ce que les participants humains n'avaient pas ;
- l'efficacité en actions n'est pas l'efficacité en coût : une session humaine de 90 minutes était payée 115 dollars, quand une évaluation du modèle se chiffre en dizaines de milliers de dollars.
Ajoutons deux points. Le billet ne définit pas précisément le calcul du pourcentage affiché. Et le branchement fournisseur repose sur des fonctions propres à OpenAI, ce qui limite la comparaison avec d'autres modèles. La fondation annonce que ses prochains rapports publieront les deux mesures, clairement étiquetées, et dit réfléchir à la prochaine génération de tests.
Notre lecture
Un banc d'essai conçu pour résister a tenu moins de six mois. Un score élevé sur un classement indique que la difficulté mesurée est franchie, pas que le modèle fera correctement votre travail.
Le résultat le plus utile pour une entreprise est l'écart entre les deux branchements. Le même modèle passe de 62,7 % à 99,9 % sans changer de poids, uniquement parce qu'il garde mieux le fil entre deux étapes, et il coûte moins cher au passage. Avant de payer pour un modèle plus puissant, vérifiez comment votre outil gère la mémoire de l'agent sur une tâche longue : conservation de l'état, compression de l'historique, prise de notes. Et lorsque vous lisez un classement, demandez dans quelles conditions le chiffre a été obtenu.
Sources
- ARC Prize — OpenAI's GPT-6 Astra on ARC-AGI-3 — source primaire