IA locale · Actualité
DGX Spark 64 Go : NVIDIA ouvre une seconde configuration à partir de 4 999 dollars
NVIDIA décline son mini-ordinateur pour l'IA locale dans une version à 64 Go de mémoire, vendue uniquement par six constructeurs. Deux unités reliées par un câble se comportent comme une seule machine de 128 Go. Ce qui est annoncé, et ce qu'il faut vérifier avant d'acheter.
Par Kayzen AI · · 3 min de lecture
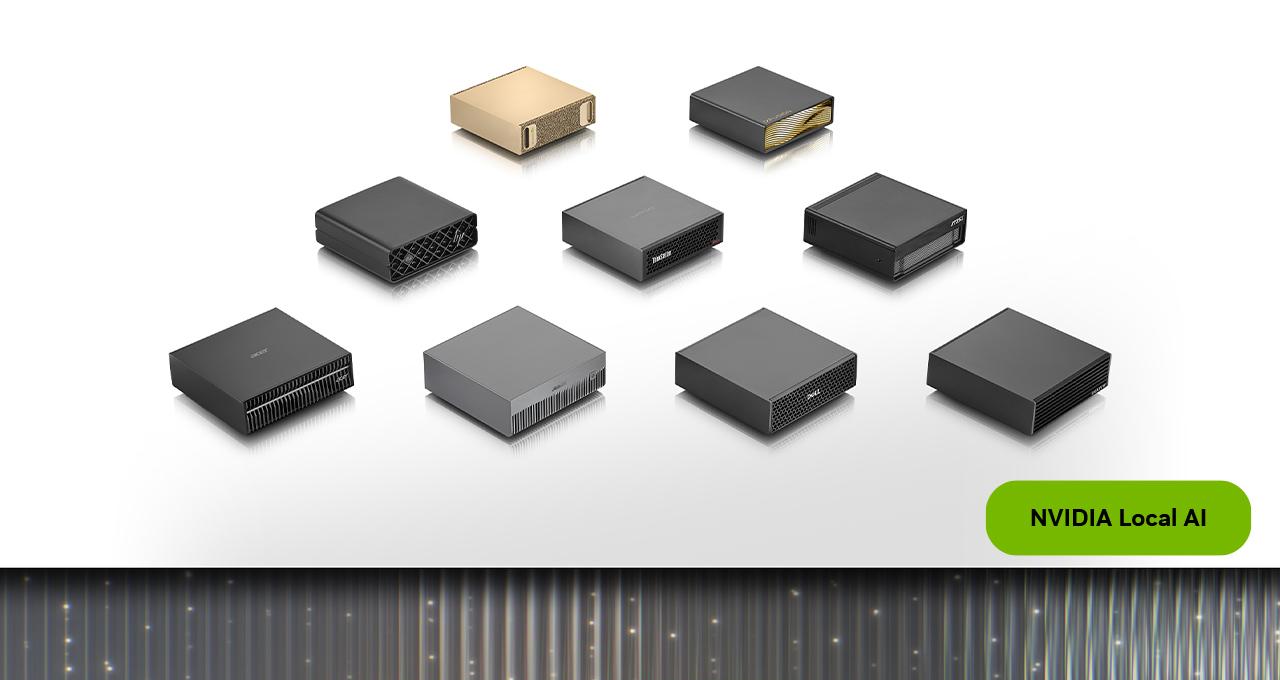
Le DGX Spark est le petit boîtier de NVIDIA destiné à faire tourner des modèles d'IA sur un bureau plutôt que dans un centre de données. Dans un billet daté du 2 octobre 2026, l'entreprise a annoncé une seconde configuration, dotée de 64 Go de mémoire unifiée au lieu de 128 Go.
Ce qui est annoncé
- Prix : à partir de 4 999 dollars.
- Disponibilité : le vendredi 23 octobre 2026, selon le billet.
- Distribution : uniquement chez les constructeurs partenaires, à savoir Acer, ASUS, Dell, Gigabyte, HP et MSI.
- Matériel : la même puce GB10 Grace Blackwell que le modèle 128 Go, et une carte réseau ConnectX-7 intégrée.
- Logiciel : le système DGX OS et la pile logicielle de NVIDIA. Ollama, vLLM et PyTorch avec CUDA sont pris en charge d'origine, indique l'entreprise.
NVIDIA affirme que cette version exécute entièrement en local des modèles allant jusqu'à 100 milliards de paramètres.
Deux boîtiers reliés par un câble
L'argument principal de l'annonce est l'évolutivité. Deux unités se relient directement par un câble QSFP entre leurs ports ConnectX-7, ce qui forme une liaison à 200 GbE. La mémoire est alors mise en commun, soit 128 Go, et NVIDIA parle de modèles jusqu'à 200 milliards de paramètres sur la paire.
Un assistant, NVIDIA Sync Cluster Assistant, détecte les unités connectées, vérifie la configuration et règle le réseau. Comme chaque boîtier utilise la même pile logicielle, passer d'une unité à deux ne demande pas de reconfiguration, selon l'éditeur.
Côté performances, NVIDIA annonce jusqu'à 1,7 fois le débit d'un seul système pour deux boîtiers de 64 Go, dans son propre essai avec le modèle Qwen 3.8 27B. Ce chiffre vient du constructeur, pas d'une mesure indépendante.
Un lanceur de modèles annoncé
Le billet annonce aussi NVIDIA Sync Model Launcher pour la fin octobre. L'outil doit télécharger et lancer Qwen3.8 27B sur un boîtier ou sur une paire, rendre le modèle accessible depuis un ordinateur portable et configurer l'agent de code OpenCode pour un usage dans le navigateur. Nous n'avons pas vérifié sa disponibilité effective.
Des guides pas à pas, que NVIDIA appelle « playbooks », sont publiés sur build.nvidia.com pour plusieurs agents. D'autres, propres aux machines de 64 Go (servir un modèle avec vLLM, relier plusieurs boîtiers), sont annoncés sans date.
Les points à vérifier
- Le prix en euros. Le billet ne donne qu'un prix de départ en dollars. Chaque constructeur fixe le sien, et le tarif français, TVA comprise, reste à relever chez le revendeur.
- Le coût de l'évolution. Arriver à 128 Go en reliant deux boîtiers revient à acheter deux machines. Il faut comparer ce total au prix d'un modèle 128 Go d'origine, que le billet ne rappelle pas.
- Le gain du couplage. Un facteur de 1,7 pour deux machines signifie que le doublement n'est pas parfait. Et il n'a été annoncé que pour un seul modèle.
- La taille des modèles. Les plafonds de 100 et 200 milliards de paramètres ne disent rien du niveau de compression appliqué ni de la vitesse obtenue.
Notre lecture
Pour une petite entreprise française, cette configuration a un intérêt précis : disposer d'un serveur d'IA compact, silencieux, avec la pile CUDA préinstallée, pour faire travailler un modèle de taille moyenne sur des données qui ne sortent pas des locaux. C'est un budget à part entière. Avant de commander, demandez un devis en euros à deux constructeurs, vérifiez la garantie et le support en France, et faites tester sur la machine le modèle que vous comptez vraiment utiliser. Si votre besoin dépasse 64 Go dès le départ, la paire de boîtiers n'est pas forcément l'option la plus économique.