IA locale · Actualité
LFM3 : Liquid AI publie six petits modèles à poids ouverts pour appareils modestes
Liquid AI a présenté le 27 octobre 2026 sa troisième génération de modèles, LFM3 : six modèles d'environ 2 milliards de paramètres pour le texte, l'image, l'audio et la prise de décision. Le modèle de texte tiendrait dans environ 1 Go de mémoire. L'éditeur reconnaît lui-même ses limites.
Par Kayzen AI · · 3 min de lecture
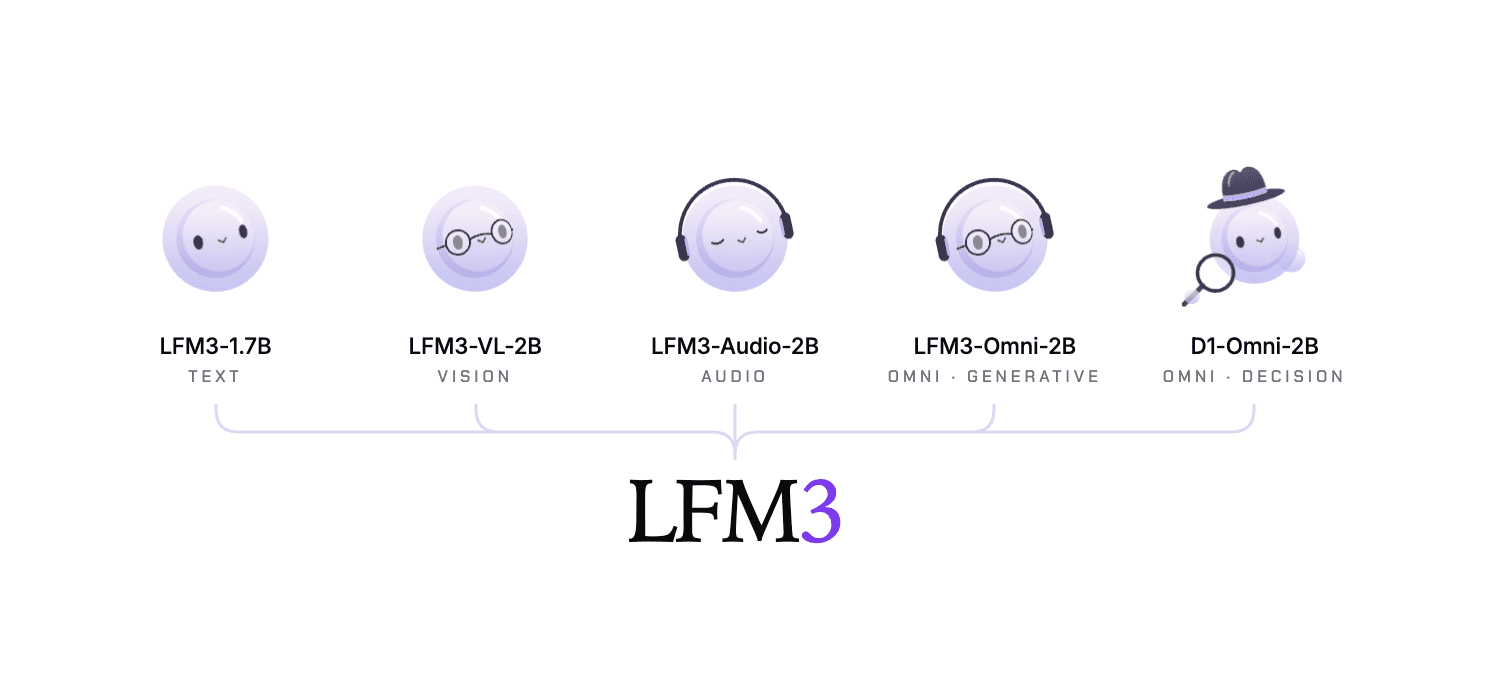
Liquid AI construit des modèles de petite taille destinés à tourner sur un téléphone, un ordinateur portable ou un boîtier industriel. Le 27 octobre 2026, elle a présenté LFM3, sa troisième génération. Le parti pris est à contre-courant des annonces habituelles : pas de modèle géant, mais une famille de modèles spécialisés qui partagent le même socle.
Ce qui est publié
La première livraison compte six modèles d'environ 2 milliards de paramètres, tous dérivés d'un même modèle de base, LFM3-1.7B-Base :
- un modèle de texte, LFM3-1.7B, avec une fenêtre de contexte de 256 000 tokens ;
- trois modèles qui acceptent d'autres entrées : image, audio, et les deux à la fois ;
- deux modèles dits « de décision », spécialisés à partir des modèles image et multimodal.
Le modèle de base et les modèles spécialisés sont publiés à poids ouverts sur Hugging Face. Ils sont aussi accessibles par l'API de Liquid AI et dans son espace d'essai en ligne.
Les chiffres annoncés
Ils viennent de Liquid AI et n'ont pas été vérifiés de façon indépendante.
- Mémoire. Le modèle de texte tiendrait dans environ 1 Go en précision 4 bits.
- Vitesse. Avec llama.cpp et un contexte de 32 000 tokens, l'éditeur annonce une génération 1,8 à 2,8 fois plus rapide que le modèle concurrent le plus rapide de sa comparaison.
- Long contexte. À 128 000 tokens, la mémoire de travail du modèle occuperait 1,6 Go, contre 4,3 Go pour Qwen3.5-4B d'après le même tableau.
- Qualité. Sur la moyenne de sa série de tests, Liquid AI place LFM3-1.7B à 49,37, devant Qwen3.5-9B à 47,24, un modèle pourtant plusieurs fois plus gros.
Là où il reste derrière
Le billet le dit lui-même : sur le code et les connaissances générales, les modèles plus gros gardent l'avantage. Le détail des tableaux le confirme.
- Sur SWE-bench Verified, un test de correction de bogues, LFM3-1.7B obtient 43,40 contre 51,20 pour Qwen3.5-9B.
- Sur GPQA Diamond, un test de questions scientifiques, 63,37 contre 80,40.
- Sur RULER à 128 000 tokens, qui mesure la tenue sur de longs documents, 65,56 contre 87,11.
Ce dernier point nuance la fenêtre de 256 000 tokens : le modèle accepte de longs textes, mais il les exploite moins bien qu'un modèle plus gros. Ses points forts sont ailleurs, dans les tâches d'agent : sur WebArena-Verified, l'éditeur annonce 38,42 contre 28,94 pour Qwen3.5-9B, et sur AutomationBench 41,29 contre 15,10.
Points à vérifier
- La licence. Le billet parle de poids ouverts sans que nous y ayons trouvé le nom de la licence. « Poids ouverts » ne veut pas dire « libre d'usage commercial » : lisez la fiche de chaque modèle sur Hugging Face avant tout projet.
- Le français. Le billet ne donne pas de résultat par langue dans la partie que nous avons lue.
- Les noms des cinq autres modèles et leurs caractéristiques précises sont à chercher dans la collection Hugging Face.
Liquid AI indique par ailleurs que chaque modèle peut être réentraîné sur une seule carte graphique, et cite AMD, Ambarella et Qualcomm comme partenaires de lancement.
Notre lecture
LFM3 n'est pas un remplaçant de votre assistant généraliste. C'est une pièce pour des tâches étroites et répétitives : trier des courriels, extraire des champs d'un formulaire, router une demande, piloter un outil. Sur ces tâches, un modèle qui tient dans 1 Go change l'équation : il tourne sur le poste de travail, sans abonnement et sans envoyer de données à l'extérieur.
Pour une petite entreprise, la bonne démarche consiste à choisir une tâche précise, à la tester d'abord avec le modèle de texte tel quel, puis à envisager un réentraînement si le résultat est proche du but. À écarter pour l'instant : l'aide à la programmation et l'analyse de très longs documents.