Recherche · Analyse
Une IA corrige un autre modèle en modifiant directement ses poids
Des chercheurs du MIT ont demandé à un grand modèle de lire et de réécrire les nombres qui composent un petit réseau de neurones, sans entraînement classique. En retouchant 0,016 % d'un petit Qwen, son score en maths passe de 8 à 48 %. Des résultats très préliminaires.
Par Kayzen AI · · 3 min de lecture
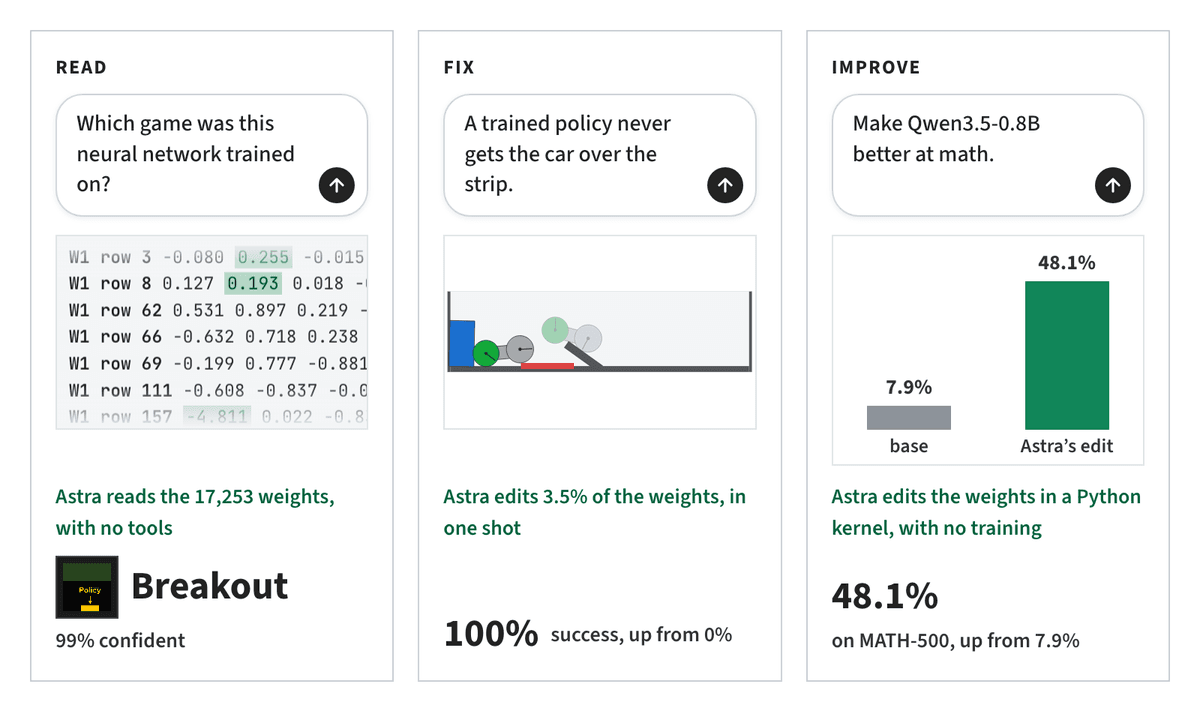
Un réseau de neurones, c'est une énorme liste de nombres, ses « poids ». Pour les régler, on passe d'ordinaire par l'entraînement : on montre des exemples, un algorithme ajuste les nombres petit à petit. Quatre chercheurs du MIT CSAIL ont essayé autre chose. Ils ont donné ces nombres à lire à un grand modèle de langage, GPT-6 Astra, et lui ont demandé de les comprendre, puis de les modifier à la main. Ils appellent cela la « programmation dans l'espace des poids ».
Leur billet, publié le 2 novembre, n'est pas un article relu par des pairs. Mais tous les journaux d'expérience sont publics.
Lire un modèle comme on lit du code
Premières expériences : faire deviner à Astra ce qu'un petit réseau a appris, uniquement à partir de ses poids.
- Face à quatre réseaux entraînés à jouer à quatre jeux vidéo différents, il nomme le bon jeu à chaque fois.
- Face à trois petits modèles de texte, il retrouve la langue d'entraînement de chacun : Python, anglais ou japonais transcrit.
Tout ne marche pas. Pour repérer lequel de deux petits modèles avait été entraîné à flatter son interlocuteur, Astra échoue quatre fois avec les poids seuls. Il n'y arrive qu'avec un outil supplémentaire pour observer le modèle en fonctionnement.
Réparer, voire écrire un modèle
Le résultat le plus frappant concerne Qwen3.5-0.8B, un petit modèle ouvert. Il tournait souvent en boucle : 93 % de ses réponses atteignaient la longueur maximale. Astra a remonté ce défaut jusqu'à une « direction » précise, écrite par deux couches du réseau, et l'a supprimée. Cela représente 131 072 nombres, soit environ 0,016 % du modèle.
Après correction :
- le score au test de maths MATH-500 passe de 7,9 % à 48,1 % ;
- celui d'IFEval, qui mesure le respect des consignes, de 21 % à 62,3 % ;
- les réponses qui butent sur la longueur maximale tombent à 33 %.
Un ingénieur de Hugging Face a reconstruit le modèle modifié à partir des journaux et retrouvé des résultats du même ordre.
Les chercheurs ont aussi demandé à Astra d'écrire des réseaux entiers sans aucun entraînement. Sur une version simplifiée du jeu Breakout, le réseau écrit à la main obtient 517 points, contre 25 pour un réseau entraîné classiquement pendant 500 millions d'étapes. Sur deux autres jeux, il fait un peu moins bien que l'entraînement classique.
Pourquoi il faut rester prudent
Les auteurs parlent eux-mêmes de résultats « très préliminaires », et leurs propres expériences montrent la limite. La même méthode appliquée à un autre petit modèle, Gemma 3 270M, n'a presque rien donné. Leur lecture : modifier les poids peut lever un blocage, pas créer une compétence que le modèle n'a pas. Qwen savait probablement déjà faire ces maths ; il était empêché de finir ses réponses.
Tout se joue aussi sur des modèles minuscules, de quelques milliers à moins d'un milliard de poids. Rien n'indique encore que cela fonctionne sur les modèles utilisés au quotidien.
Pourquoi c'est intéressant quand même
Si un modèle peut lire ce qu'un autre a appris, on peut imaginer des usages très concrets : vérifier qu'un modèle ne cache pas un comportement indésirable, lui faire « oublier » une information, ou corriger un défaut sans tout réentraîner. Les auteurs présentent ces pistes comme des possibilités, pas comme des acquis. C'est une direction à suivre, pas une technique à utiliser demain.